面向机器人操作的视觉—语言—动作模型研究
研究意义
机器人操作涉及环境感知、任务理解和动作执行。以物品归置为例,机器人需要识别物体及其位置,理解操作者指定的目标,再控制机械臂完成抓取和放置。在物品种类和工位布局相对固定的场景中,可以事先为机器人配置操作对象、运动路径和动作顺序。当工作环境、任务目标或物体摆放发生变化时,机器人还需要根据当前观测重新决定动作,这对系统的适应能力提出了更高要求。
视觉—语言—动作模型(Vision-Language-Action Model,VLA)为解决这类问题提供了一种途径。这类模型以相机图像和自然语言指令作为主要输入,部分模型还会使用关节位置、夹爪状态等信息,输出机器人能够执行的动作。例如,用户希望将桌上的可回收物放入指定容器,语言给出物品类别和放置目标,图像提供物体分布、容器位置及周围障碍的信息。模型需要将这些线索对应到当前场景,并据此决定机械臂如何移动、夹爪何时闭合以及物体应当放在哪里。语言指令使操作者能够用较自然的方式指定任务,也使机器人面对的目标更加多样。相同的桌面布局下,“把杯子放进托盘”和“把杯子递给旁边的人”对放置位置和交接姿态有不同要求。同一条指令在物体位置发生变化时,也可能需要采用不同的接近方向和抓取动作。VLA 的研究重点之一,就是让模型在感知、语义与动作之间建立联系,使操作方式能够随任务和环境变化而调整。
这类研究也与机器人技能的复用有关。在家居服务、仓储拣选和柔性制造等应用中,机器人往往需要处理多种物体并执行不同操作。如果同一个模型能够从多种任务和平台的示范中学习,再用目标平台的数据进行适配,就有机会复用已有的视觉知识和操作经验。与此同时,动作是否可执行也取决于机器人结构、控制接口和现场条件。如何让模型理解指令、生成可执行动作,并在不同场景中保持可靠性,是 VLA 研究需要共同回答的问题。
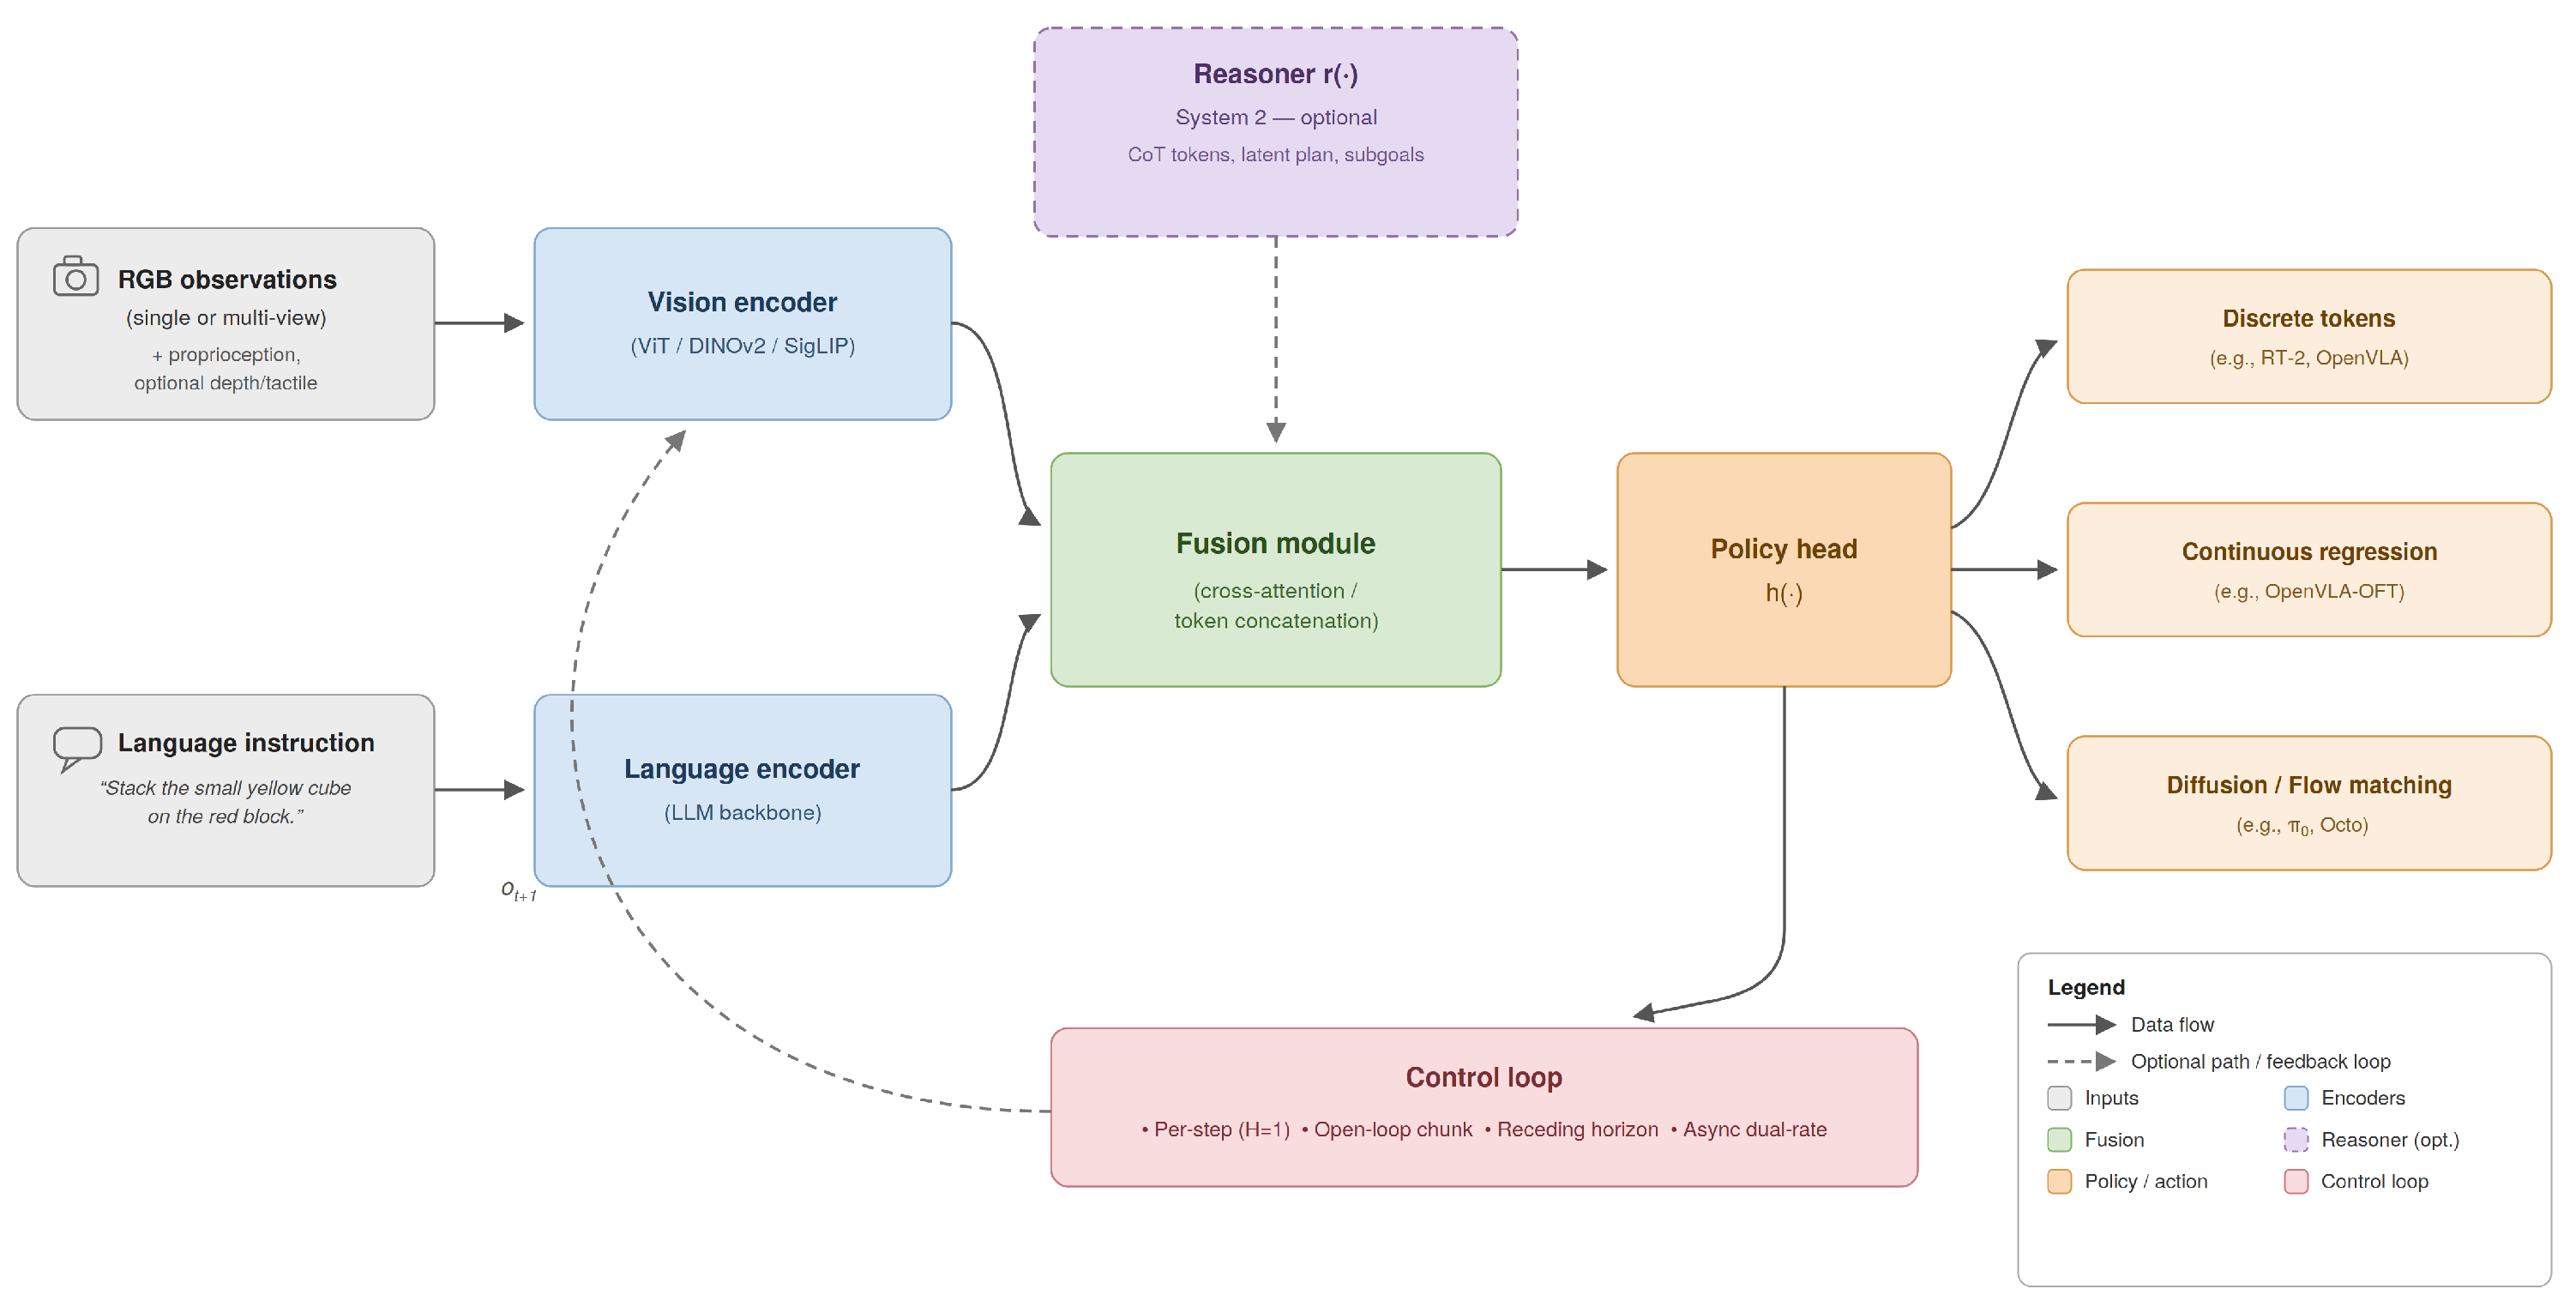
图1 视觉—语言—动作模型的输入、动作输出与执行反馈示意。
国内外研究现状
视觉、语言与动作的联合建模
视觉—语言模型能够根据图像和文字提取与任务有关的信息。要将这种能力用于机器人操作,还需要建立从信息表征到控制指令的映射。机器人的动作可以表示为末端执行器的位置或姿态变化,也可以表示为关节目标和夹爪指令。不同平台对动作的定义和执行频率有所区别,模型输出需要与相应的机器人控制接口匹配。
RT-2 将机器人的连续控制量离散为可用符号表示的动作。例如,可将一段位移范围划分成多个区间,由模型预测对应的动作符号,再将符号转换为控制量。这样,模型可以沿用视觉—语言模型处理序列的方式学习机器人动作。OpenVLA 延续了这类动作表示方式,将预训练视觉特征、语言模型与大规模机器人操作示范结合,并提供公开模型与微调方法,便于研究者在新的操作场景中进行适配[1] [2]。另一类方法直接生成连续动作序列。π₀ 采用流匹配方法,根据图像、指令和机器人状态生成接下来一小段连续动作。RDT-1B 则使用扩散模型生成双臂机器人的动作,并通过多种机器人数据进行预训练。连续动作序列能够把移动手臂、调整姿态和开合夹爪等动作放在一起考虑,对于折叠织物或双臂协调等操作具有实际意义[3] [4]。
动作生成还要与实时执行相配合。一次生成一小段动作,有助于维持相邻动作之间的连贯性。执行一部分后更新图像和机器人状态,可以让后续动作依据实际结果重新生成。例如,搬运物体时,夹爪闭合之后物体的位置可能发生变化,下一段动作就需要利用新的观测。预测和执行之间的时间安排,会同时影响运动的流畅性、反馈速度和计算负担。动作表示的选择还会改变模型需要学习的内容。离散表示将控制量转换为有限个符号,便于沿用序列预测框架,动作精度受离散区间的划分影响。连续生成可以直接表示幅度不同的移动和姿态调整,实际部署时需要考虑生成速度是否与控制频率匹配。预测多少步、实际执行多少步,则是与动作表示相关的另一项设计选择。
机器人操作数据与跨任务迁移
机器人示范通常由连续的观测和动作组成,并配有相应的任务描述。一条分拣示范可以记录从接近目标、抓住物体到将其放入容器的全过程。模型训练时,可以根据示范中的图像、指令和机器人状态,学习在当时条件下应当执行的动作。数据的覆盖范围会影响模型遇到新物体、新摆放方式和新任务时可以借鉴的经验。对于同一个放置目标,示范可以从不同物体位置开始,也可以采用不同的接近方向。这样的变化使模型有机会学习任务要求与现场条件之间的关系,避免把某一条固定路线与整项任务过度关联。
Open X-Embodiment 汇集多种机器人平台的操作轨迹,并将不同来源的数据组织为统一格式,为跨任务和跨机器人训练提供了基础。其研究表明,在所测试的平台和任务上,来自其他机器人的操作经验可以帮助模型学习目标平台的任务。跨平台迁移仍涉及动作表示的对齐。例如,两台机械臂即使执行相同的放置任务,关节数量、夹爪开合方式和工作空间也可能不同,控制量需要结合各自的硬件条件来解释[5]。
不同来源的数据还可以承担不同作用。图像与文字数据可以为模型提供物体类别、用途和空间关系等信息,机器人示范则记录实际操作中的运动过程。π₀.₅ 将多平台机器人数据、视觉语义任务和其他来源的数据结合训练,并在训练中未出现的家庭环境中测试物品收拾等长时序操作。此类工作说明,评估模型能否适应新环境时,需要同时关注视觉语义能力和实际操作经验如何迁移[6]。
泛化能力与执行效果评估
VLA 的泛化能力可以从物体、指令、场景和硬件等维度考察。例如,在保持任务目标相同的情况下,可以改变物体的外形、尺寸和摆放位置。在保持场景相近的情况下,可以改变指令中的目标物体或空间关系。LIBERO 为机器人操作研究提供了由物体、空间布局和任务目标等因素构成的仿真任务,有助于研究者在可重复的条件下分析模型的迁移能力[7]。
真实环境的评估还需要观察完整的执行过程。以插接零件为例,选中正确的零件、保持合适的抓握与朝向、最终完成对接,分别反映了任务理解、动作执行和任务完成情况。对于需要多次抓取与放置的任务,早期动作中的位置偏差也可能影响后续操作。因此,除了统计任务成功率,还可以记录失败发生的阶段、外部干预次数和执行时间,以便定位限制系统表现的环节。对于跨平台比较,还应明确目标机器人是否参与训练、测试前是否使用了该平台的示范,以及动作接口如何适配。
参考文献
- [1]M. J. Kim, K. Pertsch, S. Karamcheti, T. Xiao, A. Balakrishna, and others, “OpenVLA: An Open-Source Vision-Language-Action Model,” in Proceedings of the 8th Conference on Robot Learning, 2025, vol. 270, pp. 2679–2713.
- [2]K. Black, N. Brown, D. Driess, A. Esmail, M. Equi, and others, “π₀: A Vision-Language-Action Flow Model for General Robot Control,” in Robotics: Science and Systems XXI, 2025.
- [3]S. Liu et al., “RDT-1B: A Diffusion Foundation Model for Bimanual Manipulation,” in International Conference on Learning Representations, 2025.
- [4]K. Black, N. Brown, J. Darpinian, K. Dhabalia, D. Driess, and others, “π₀.₅: A Vision-Language-Action Model with Open-World Generalization,” in Proceedings of the 9th Conference on Robot Learning, 2025, vol. 305, pp. 17–40.
- [5]B. Zitkovich, T. Yu, S. Xu, P. Xu, and others, “RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control,” in Proceedings of the 7th Conference on Robot Learning, 2023, vol. 229, pp. 2165–2183.
- [6]Open X-Embodiment Collaboration and others, “Open X-Embodiment: Robotic Learning Datasets and RT-X Models,” arXiv preprint arXiv:2310.08864, 2023.
- [7]B. Liu et al., “LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning,” in Advances in Neural Information Processing Systems, Datasets and Benchmarks Track, 2023.