面向人类有限理性的基于信息增益的主动权限分配框架
论文相关信息
本文内容取自[1]。
研究背景与意义
共享控制通过融合人的判断能力与机器的计算、执行能力,使两者共同完成驾驶、手术和机器人遥操作等任务,从而降低操作负担并提高任务安全性与执行效率[2], [3]。但机器只有理解人的真实意图,才能提供方向正确、时机合适的辅助。
现实中的操作者通常具有“有限理性”。即使任务信息可见,人也可能因认知能力、操作经验或对系统动力学不熟悉,无法实时给出全局最优动作,而只能依据局部信息和经验操作[4], [5]。因此,人的控制输入既携带意图信息,又包含随机性、延迟和偏差,机器很难通过单次观测准确判断目标。
已有方法通常根据当前意图估计或置信度生成辅助,却较少考虑当前权限决策对未来意图推断的影响[6], [7], [8]。如果机器过早主导控制,可能持续强化错误的目标判断;如果始终给予人较高权限,又可能牺牲即时任务性能。为此,本文提出基于信息增益的主动权限分配框架 IG3A(Information-Gain-based Active Authority Allocation),在即时任务执行与主动意图探索之间进行在线权衡。
本文方法
本文采用线性融合的共享控制结构。操作者根据私有意图产生输入,自主系统根据历史状态和人类输入维护意图信念,并针对当前最可能的意图生成辅助动作。IG3A 仲裁器不只响应当前置信度,还预测不同权限选择对下一步意图信息的影响。
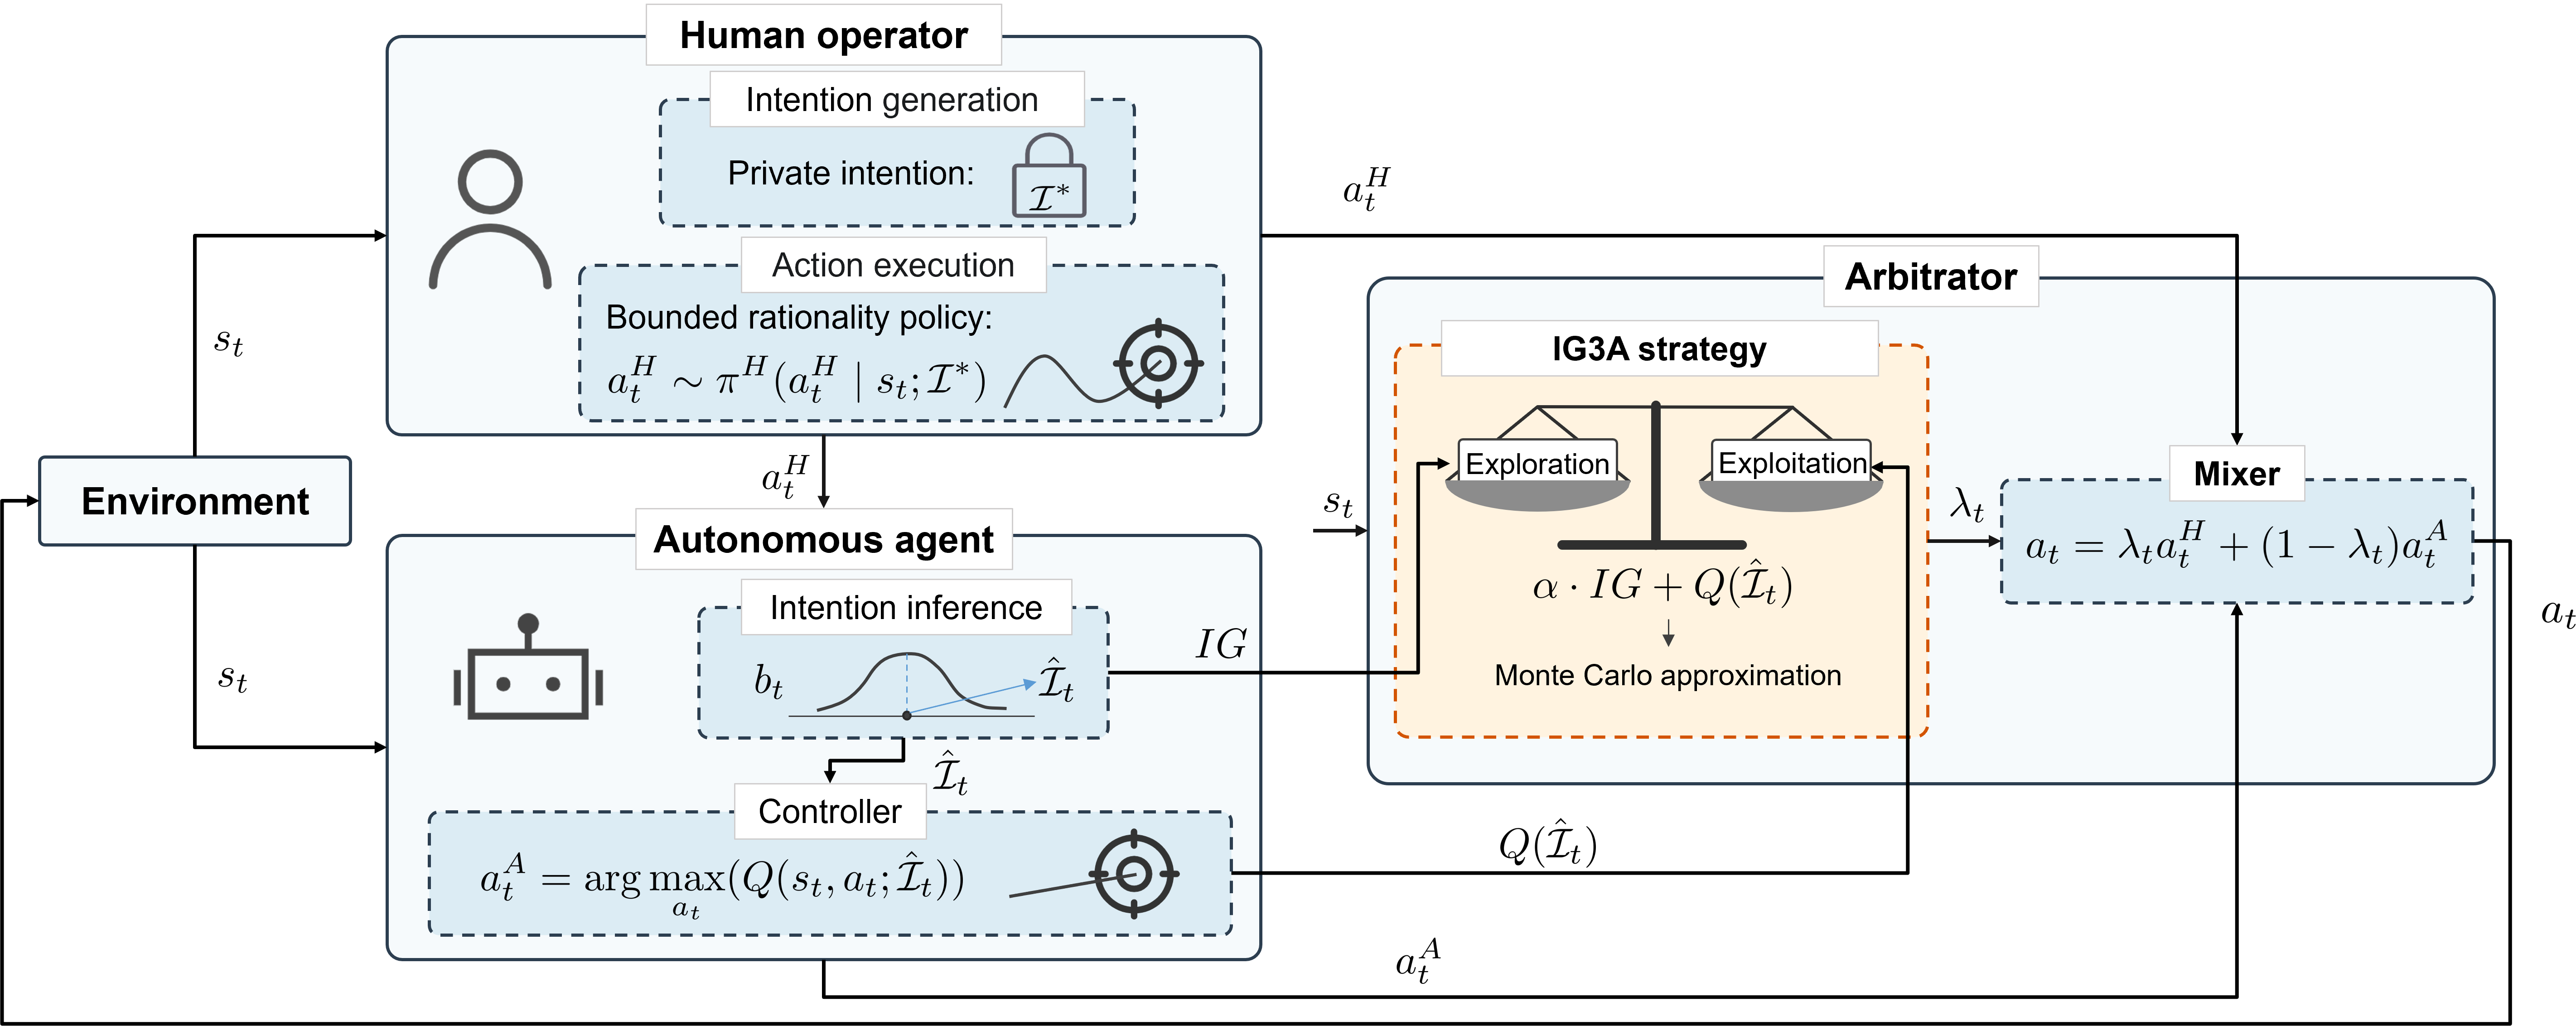
图1 IG3A 框架:仲裁器同时权衡任务利用与意图探索
有限理性下的共享控制建模
设时刻 $t$ 的人类输入为 $a_t^H$,自主辅助动作为 $a_t^A$,最终执行动作为 $a_t$。线性融合关系写为:
\[a_t = \lambda_t a_t^H + (1-\lambda_t)a_t^A,\]其中,$\lambda_t\in[0,1]$ 是人的权限系数,数值越大,人的输入影响越强。本文用与任务价值相关的随机策略描述有限理性行为:高价值动作更可能出现,但单次输入不足以确定真实意图。自主系统通过贝叶斯更新维护意图信念 $b_t(\mathcal{I})$,并针对最大后验意图 $\hat{\mathcal{I}}_t$ 生成辅助动作。
$\lambda_t$ 同时影响当前执行动作和下一状态,而下一状态又会影响人的后续输入及信念更新。因此,权限分配既是动作融合问题,也是信息获取问题。直接进行长时域信念空间优化计算量过高,难以用于实时控制。
基于信息增益的主动权限分配
IG3A 使用单步代理目标近似长时域优化:
\[Q_{\text{sur}}(b_t,s_t,\lambda_t) =Q\bigl(s_t,a_t(\lambda_t);\hat{\mathcal{I}}_t\bigr) +\alpha\left[H(b_t)-\mathbb{E}\!\left(H(b_{t+1}\mid\lambda_t)\right)\right].\]第一项衡量当前融合动作的任务价值,第二项是当前信念熵与下一步期望信念熵之差,即预期信息增益;$\alpha$ 用于调节任务利用与意图探索的相对重要性[9]。当意图不明确时,信息增益鼓励选择更有利于人表达目标的权限;当意图已经明确时,任务价值项促使系统专注于完成任务。
为满足在线计算要求,IG3A 将连续权限系数离散为有限候选值,并利用蒙特卡洛采样预测每个候选值对应的下一状态、人类响应和后验信念。系统据此估计期望信息增益,最终选择代理目标最大的权限系数。该过程把难以求解的长时域问题转化为可调节采样预算的单步在线优化。
实验结果
本文通过模拟人 LunarLander、真实参与者 LunarLander 和六自由度机械臂三类实验验证 IG3A。对比方法包括基于当前意图置信度的 CB、基于信念空间规划的 HO 和学习式干预方法 IDA。CB、HO 与 IG3A 使用相同的意图推断和自主控制模块,以突出权限分配策略本身的影响。
模拟实验设置了目标切换、外部扰动和不同程度的有限理性输入。在最困难的低理性条件 $\beta_H=0.1$ 下,IG3A 获得最高的成功率和总回报,且相对三种基线的提升均具有统计显著性。随着人的输入更加符合目标,方法间差距缩小,表明主动探索主要在意图证据较弱或发生变化时发挥作用。
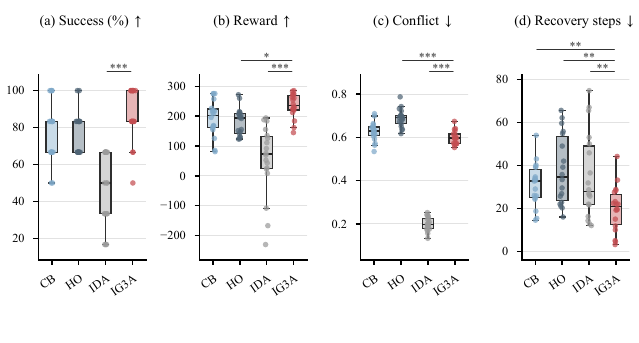
图2 18 名参与者参与的 LunarLander 人在回路实验结果
在人在回路 LunarLander 实验中,18 名参与者使用 Xbox 手柄完成目标切换任务。IG3A 取得最高的整体成功率和任务回报;与 CB 和 HO 相比,它还降低了人机指令冲突,并用更少步骤识别切换后的新意图。这说明方法的收益并非只存在于模型生成的理想化输入中。
在由 Realman RM-65B 机械臂、深度相机和 SpaceMouse 构成的真实平台上,15 名参与者完成了多种目标切换任务。IG3A 所需的初始意图收敛步数和切换后恢复步数最少,人机冲突也低于 CB 与 HO。系统以 $5\,\mathrm{Hz}$ 运行时,IG3A 权限仲裁平均耗时为 $31.84\pm0.91\,\mathrm{ms}$,完整控制回路平均耗时为 $102.77\pm1.23\,\mathrm{ms}$,满足 $200\,\mathrm{ms}$ 的控制周期要求。
综合来看,IG3A 并非一味追求最快降低意图不确定性,而是动态判断当前更需要完成任务还是获取更有辨识度的人类输入。当意图证据不确定或发生变化时,这种利用—探索权衡能够改善整体共享控制性能。当前方法仍依赖线性融合和有限、已知的意图集合,未来可进一步研究非线性仲裁、未知意图检测及更复杂物理任务中的人机适应。
参考文献
- [1]Y.-S. Zhao et al., “IG3A: An Information-Gain-based Active Authority Allocation Framework for Shared Control under Human Bounded Rationality,” IEEE Trans. Autom. Sci. Eng., 2026.
- [2]C. Yang, Y. Zhu, and Y. Chen, “A Review of Human-Machine Cooperation in the Robotics Domain,” IEEE Trans. Human-Mach. Syst., vol. 52, no. 1, pp. 12–25, 2022.
- [3]S. Jain and B. Argall, “Probabilistic Human Intent Recognition for Shared Autonomy in Assistive Robotics,” ACM Trans. Hum.-Robot Interact., vol. 9, no. 1, pp. 1–23, 2020.
- [7]M. A. Goodrich and A. C. Schultz, “Human–robot interaction: a survey,” Found. Trends Hum.-Comput. Interact., vol. 1, no. 3, pp. 203–275, 2008.
- [8]H. A. Simon, “A behavioral model of rational choice,” Quart. J. Econ., vol. 69, no. 1, pp. 99–118, 1955.
- [9]C. E. Shannon, “A mathematical theory of communication,” Bell Syst. Tech. J., vol. 27, no. 3, pp. 379–423, 1948.